
AI 视频
AI 人像 Y2K 变装视频
用同一套镜头约束生成可比较的人像变装视频提示词,兼顾人物一致性、动作与 Y2K 视觉风格。
更新于 2026-08-10
#人像视频#Y2K#变装#提示词#模型对比
先看看实际效果
查看原内容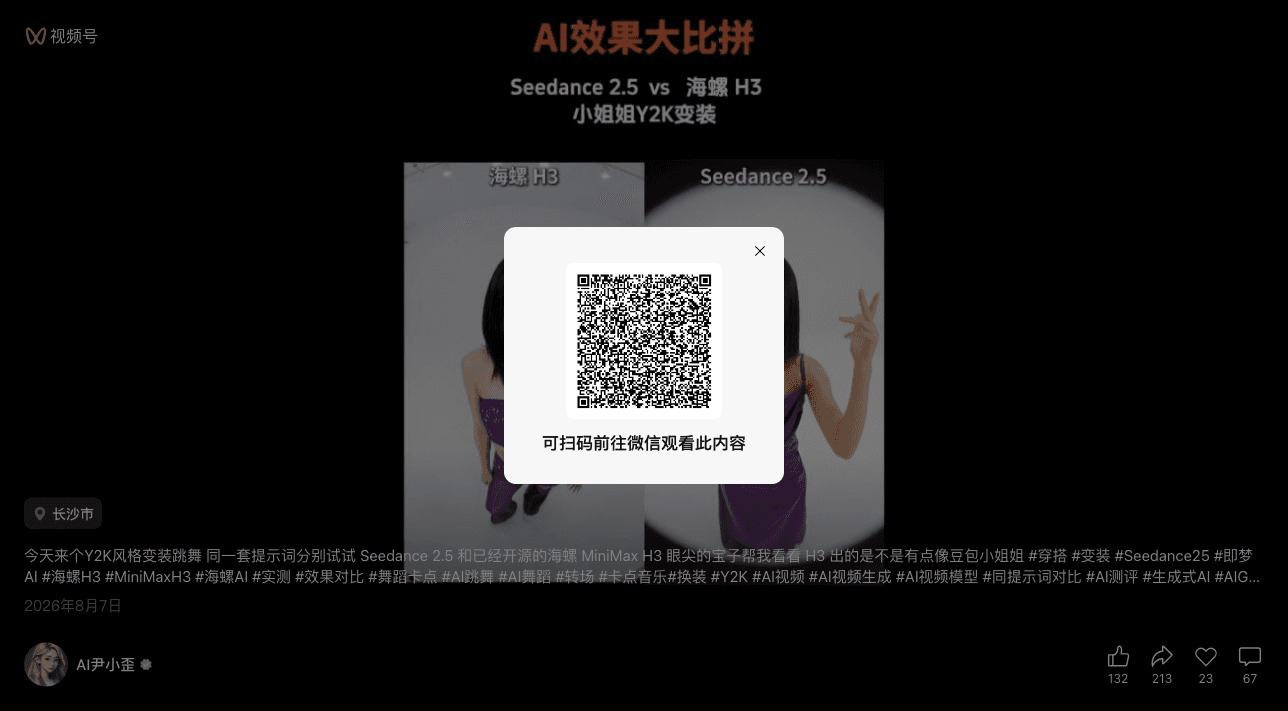

内容作者:AI尹小歪
完整技能内容
SKILL.md
---
name: y2k-portrait-video
description: Use when 生成人像变装、舞蹈卡点或转场类 AI 视频,尤其是需要锁定人物身份、按时间轴控制动作,或用同一提示词公平比较多个视频模型时。
---

# Y2K Portrait Video

## Overview

为人像变装视频建立可执行的时间轴、身份锁定和视觉约束,并在模型对比时控制变量。

**核心原则:先定义不可变化的身份与测试条件,再描述动作、转场和风格。**

## When to Use

在以下情况使用:

- 参考人像需要保持五官、发色、肤色和身形一致
- 视频包含变装、舞蹈卡点、闪光或遮挡转场
- 需要 Y2K、数码相机直闪、霓虹卧室等明确视觉语言
- 使用 Seedance、海螺、即梦或其他模型做同提示词对比
- 生成结果出现换脸、肢体穿模、动作中断或服装提前变化

不用于未经许可复刻真实人物,或生成误导性的身份与事件内容。

## Required Input

开始前收集:

1. 有权使用的参考人像或人物描述
2. 目标模型、画幅、时长和分辨率
3. 初始造型与变装后的完整造型
4. 动作、转场触发点和音乐节拍
5. 场景、光线、镜头和风格
6. 是生成成片,还是进行多模型对比

缺少参考图、时长或目标造型时先询问,不凭空决定人物身份特征。

## Workflow

### 1. 锁定不变量

建立整个视频都不得变化的约束:

- 人物:面部结构、发色、肤色、年龄表现、身形
- 镜头:机位高度、焦段感、景别、运动方式
- 场景:空间布局、主光方向、背景物体
- 输出:时长、画幅、帧率或模型提供的等价设置

模型对比时还要锁定参考图、随机种子和全部生成参数。

### 2. 编排时间轴

按秒描述可见动作,不使用“然后变得更酷”一类抽象指令。

默认六秒结构:

| 时间 | 画面任务 |
|---|---|
| 0–2 秒 | 正面中景,人物完成简单且可连续的预备动作 |
| 第 2 秒 | 用甩头、手掌遮挡或闪光完成单一转场 |
| 2–6 秒 | 新造型完整出现,人物延续同方向动作并在结尾稳定定格 |

每个时间段只设置一个主要动作。避免同时要求旋转、跳跃、换装和镜头环绕。

### 3. 编写主提示词

使用以下顺序:

```text
[主体与身份锁定]
[画幅、时长、镜头与场景]
[0–2 秒动作]
[转场时刻与遮挡方式]
[2–结束动作与最终造型]
[光线、材质与 Y2K 风格]
[必须避免的问题]
```

Y2K 视觉可以使用:银色短外套、低腰牛仔、彩色发夹、粉蓝霓虹、数码相机直闪、轻微鱼眼、低饱和颗粒。只选择与目标画面有关的元素,不堆砌标签。

### 4. 添加负向约束

明确禁止:

- 换脸、五官漂移、年龄突变
- 多余手指、肢体穿模、关节反向
- 服装在转场前提前变化
- 背景跳变、镜头瞬移、无指令缩放
- 动作中断、倒放感、转场后人物位置不连续
- 水印、文字和无关人物

### 5. 多模型公平对比

同一轮测试中不得修改:

- 提示词及其顺序
- 参考首帧
- 时长、比例、分辨率
- 随机种子或最接近的确定性参数

每个模型至少生成三次,记录中位表现,避免用单个偶然结果下结论。

## Output

```markdown
## 生成设置
- 模型:
- 时长与画幅:
- 参考素材:

## 主提示词
[可直接粘贴到模型的完整提示词]

## 负向约束
[可直接粘贴的负向提示词]

## 时间轴
[逐段说明]

## 对比记录
| 模型 | 身份一致性 | 动作完成度 | 转场稳定性 | 风格还原 | 主要问题 |
|---|---:|---:|---:|---:|---|
```

## Common Mistakes

- **提示词只有风格词**:模型需要时间轴和可见动作,而不是标签集合。
- **一秒内安排多个动作**:降低动作密度,优先保证连续性。
- **边测试边改提示词**:模型对比必须控制变量。
- **只生成一次**:至少三次才能区分能力与随机波动。
- **忽略授权**:确认人物素材和音乐可以用于目标场景。
标签
暂无标签。
作者自填
#人像视频#Y2K#变装#提示词#模型对比